Our Story
CT는 환각을 잡는 회사로 시작했습니다. 금융, 법률, 의료처럼 AI가 한 번 틀리면 곧바로 손실이나 책임 문제로 이어지는 산업에서, “AI 답변 중 틀린 것을 찾아내는 기술”이 있으면 도입의 마지막 벽을 넘을 수 있을 거라고 믿었습니다.
그래서 당시 시장이 하던 방식대로 했습니다. 이미 만들어진 에이전트의 답변을 받아서, 근거와 대조하고, 모델로 재검증하고, 틀린 것을 표시하는 탐지 기술에 집중했습니다. 기술 자체는 발전했고 탐지율도 올라갔습니다.
그런데 현장에서 세 가지 벽에 부딪혔습니다.
틀렸다는 건 알아도 왜 틀렸는지를 알 수 없었습니다. 답변만 보고는 원인이 낡은 문서인지, 잘못 잘린 자료인지, 검색이 엉뚱한 걸 가져온 건지, 모델의 착오인지 구분이 안 됐습니다. 원본 데이터부터 답변까지의 경로가 시스템 여러 곳에 흩어져 있어서 되짚어 갈 길이 없었기 때문입니다.
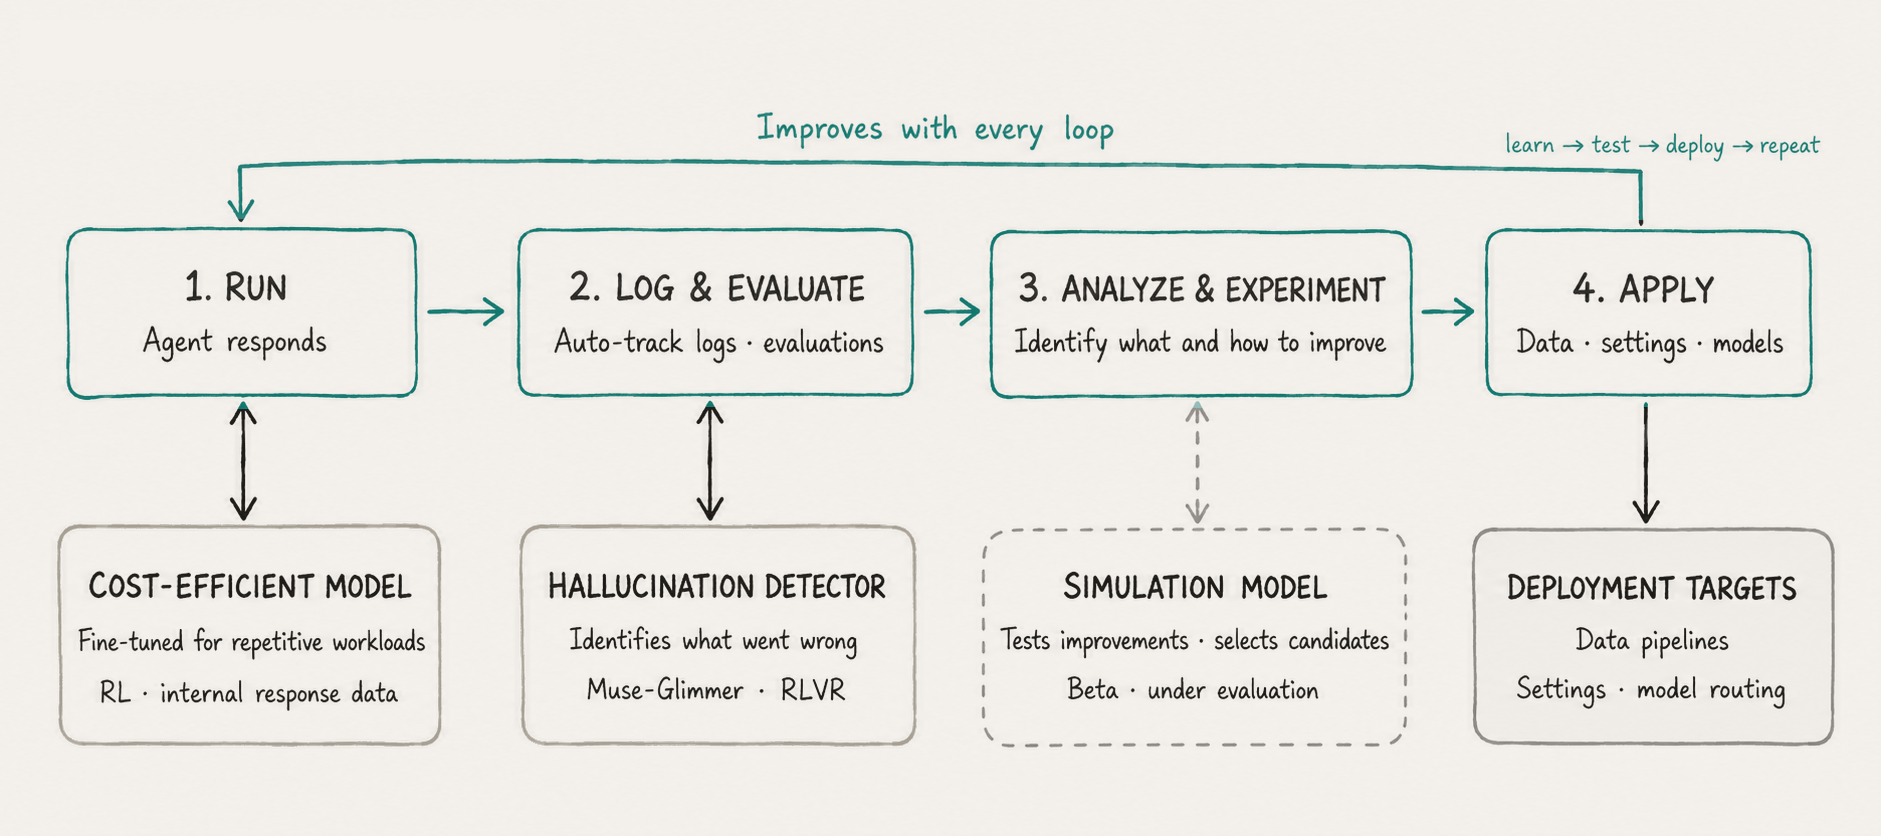
찾아낸 문제가 개선으로 이어지지 않았습니다. 탐지 결과를 넘겨도, 데이터를 고치고 설정을 바꾸고 다시 평가하는 일은 고객사 엔지니어의 몫이었습니다. 그 엔지니어들은 이미 바빴고, 결과적으로 같은 유형의 환각이 몇 달째 반복되는 것을 지켜봐야 했습니다.
탐지는 항상 뒤늦었습니다. 환각은 답변이 만들어진 뒤에 잡는 것이 아니라, 데이터가 준비되고 검색되고 조합되는 과정에서 이미 결정되고 있었습니다. 마지막 단계에서 아무리 정교하게 걸러도 상류에서 만들어지는 문제의 속도를 따라갈 수 없었습니다.
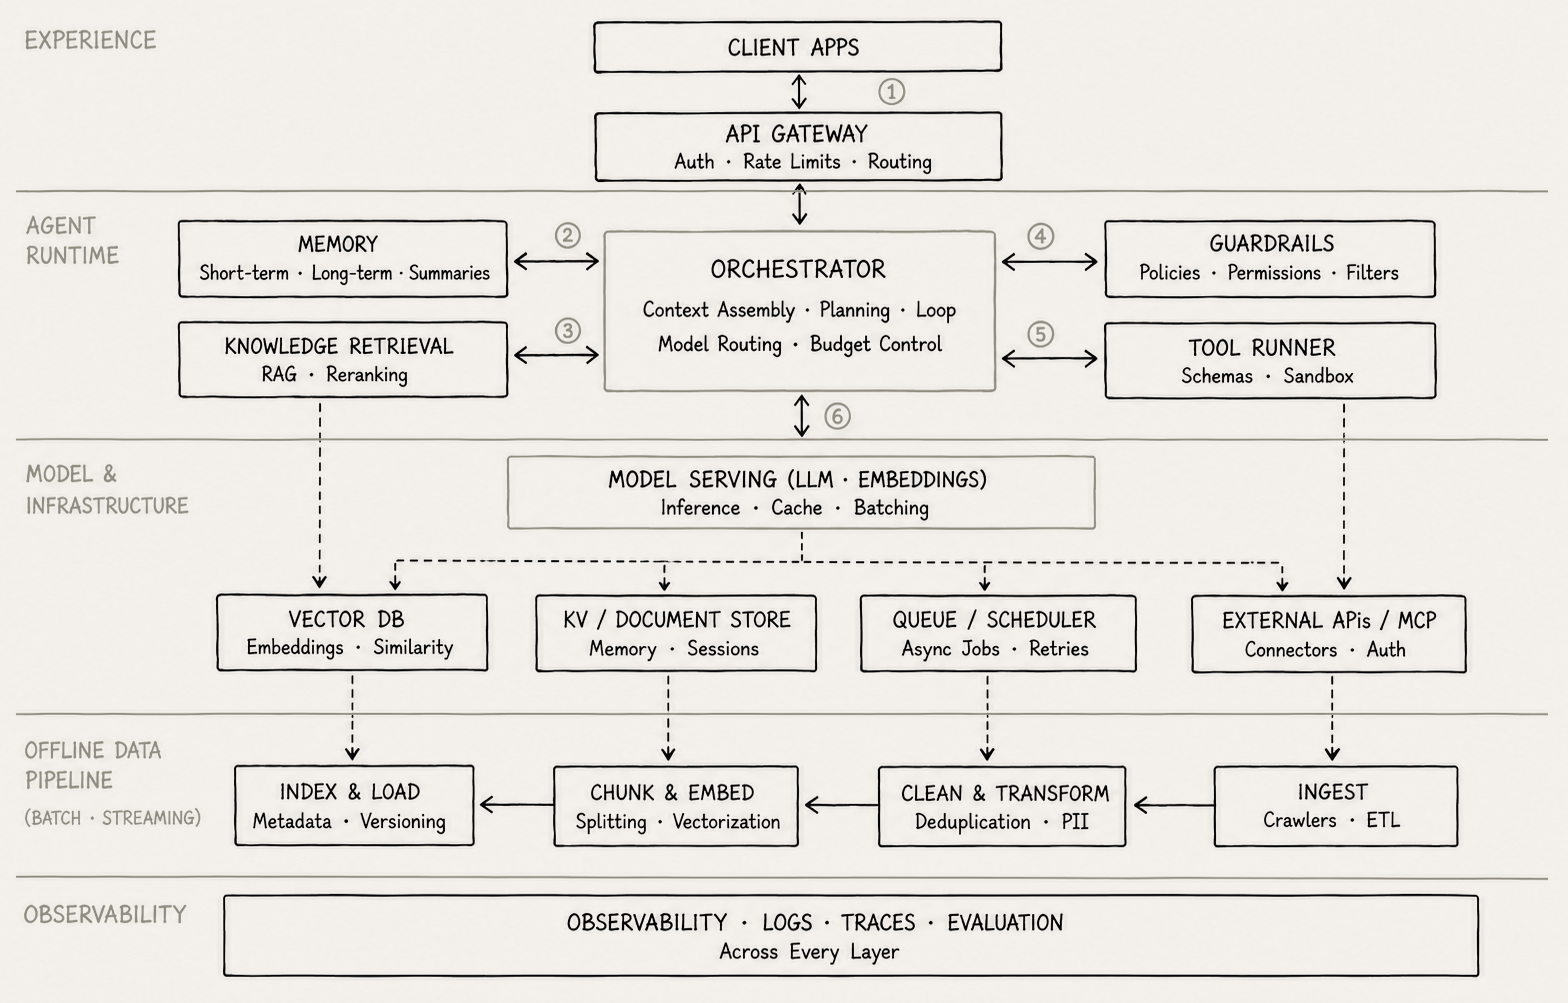
여기서 우리는 방향을 바꿨습니다. 환각은 “탐지”의 문제가 아니라 시스템 전체의 문제였습니다. 원본 데이터부터 답변까지 한 줄로 이어져 있어야 원인을 찾을 수 있고, 찾은 원인이 사람 손을 거치지 않고 다시 데이터와 설정에 반영돼야 개선이 멈추지 않습니다. 그래서 CT는 탐지 도구가 아니라, 에이전트를 만들고 운영하는 전 과정을 하나로 묶고 스스로 개선되게 하는 시스템을 만들기로 했습니다.
환각 탐지에서 시작한 회사가 결국 시스템 계층 전체를 만들게 된 이유는 하나입니다. 환각을 정말로 줄이려면, 그것이 만들어지는 곳 전체를 다뤄야 한다는 것을 현장에서 배웠기 때문입니다.